概述
AnewMind 是集成于 AnewDDE 的千亿参数级大语言模型,采用全参数后训练强化其在药物研发场景中的专业知识、构效关系推理和多阶段决策能力。模型支持 ADMET 与可开发性分析、相对排序、候选优先级判断及复杂研发问题推理。其能力通过 ADMET 与可开发性任务,以及由制药研发专家设计的内部基准 PharmBench 进行系统评价。评测结果显示,AnewMind 在 ADMET 分析与制药研发推理方面的综合表现可与全球领先的前沿大模型相媲美。
核心成果
领域增强与通用能力兼顾
经全参数领域后训练后,AnewMind 在 MMLU-Pro 和 GPQA Diamond 等通用知识与科学推理基准上仍保持竞争力,表明模型在强化制药研发能力的同时,较好地保留了通用知识和推理能力。
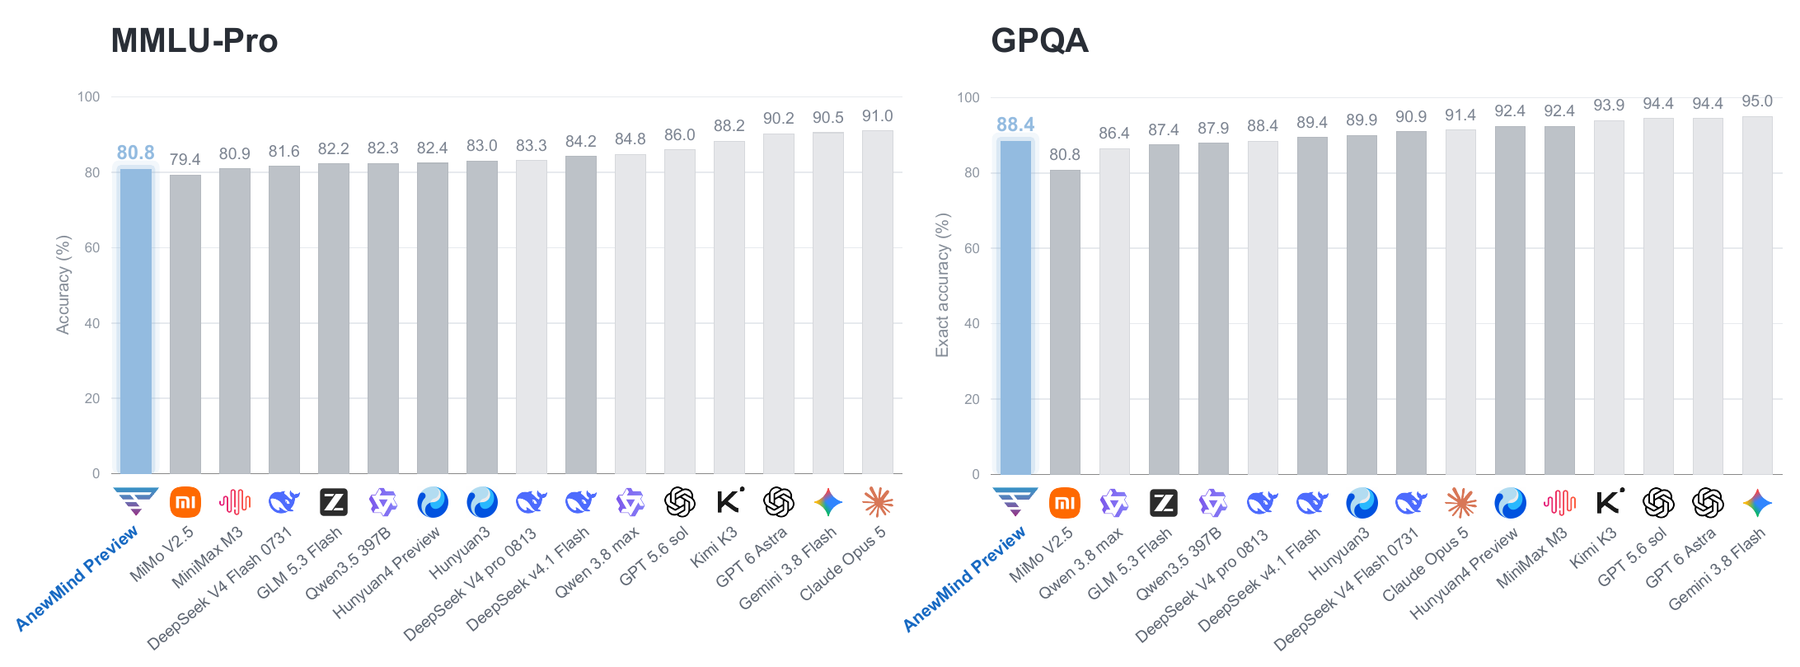
图 1. MMLU-Pro(左)和 GPQA Diamond(右)通用基准评测结果。柱状图表示准确率,其中 AnewMind Preview 以蓝色突出显示,外部模型以灰色表示。
跨模态 ADMET 与可开发性评估
AnewMind 采用更贴近研发决策的相对排序方式评估候选分子,覆盖小分子 ADMET、环肽渗透性和抗体可开发性。在与前沿模型的统一比较中,AnewMind 在四项总体评测中均位列前五:环肽渗透性排名第一,抗体可开发性接近最高水平,并在多个 CYP 抑制端点上取得领先结果。
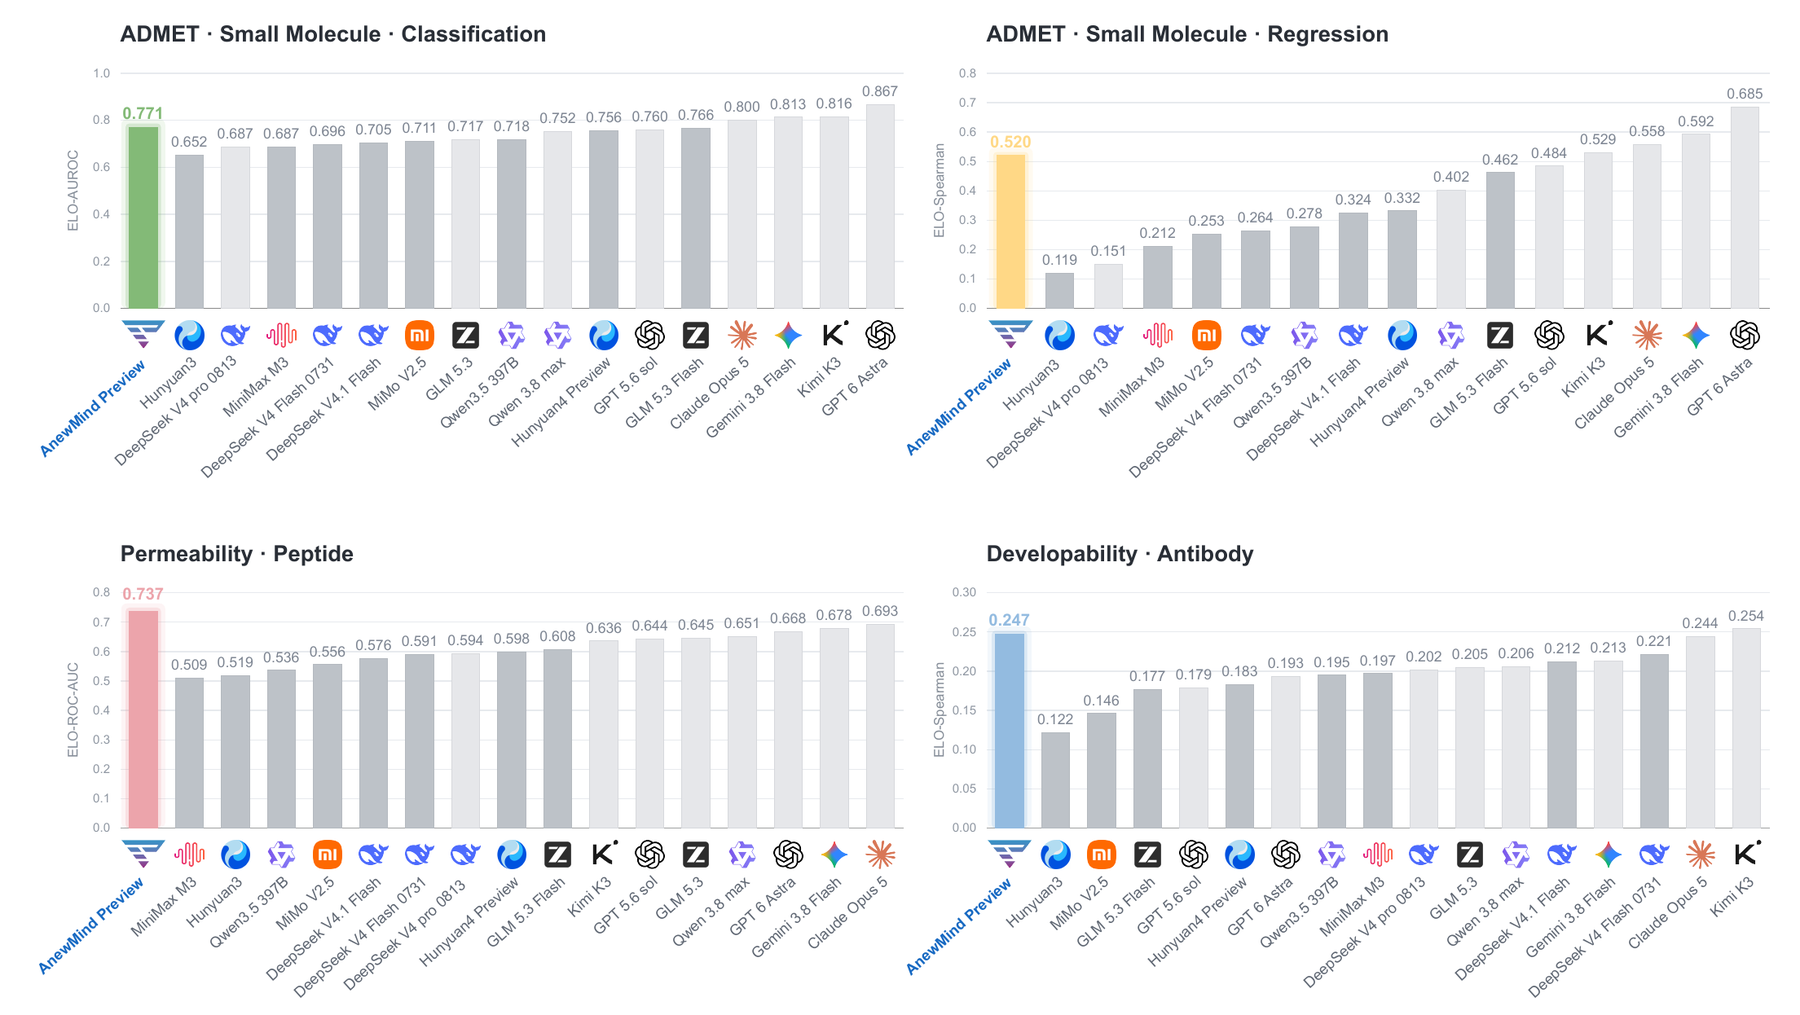
图 2. ADMET 与可开发性基准评测。比较模型在小分子 ADMET 分类与回归、多肽渗透性以及抗体可开发性任务中的预测表现。彩色柱表示 AnewMind Preview;分数越高表示性能越好。
面向制药场景长程推理的 PharmBench
PharmBench 由制药研发专家围绕真实药物发现案例设计,通过逐步呈现项目背景与实验依据,评估模型的证据整合与研发决策能力。AnewMind 在多数能力维度和案例中展现出稳定优势,总体表现可与全球领先的前沿大模型相媲美。
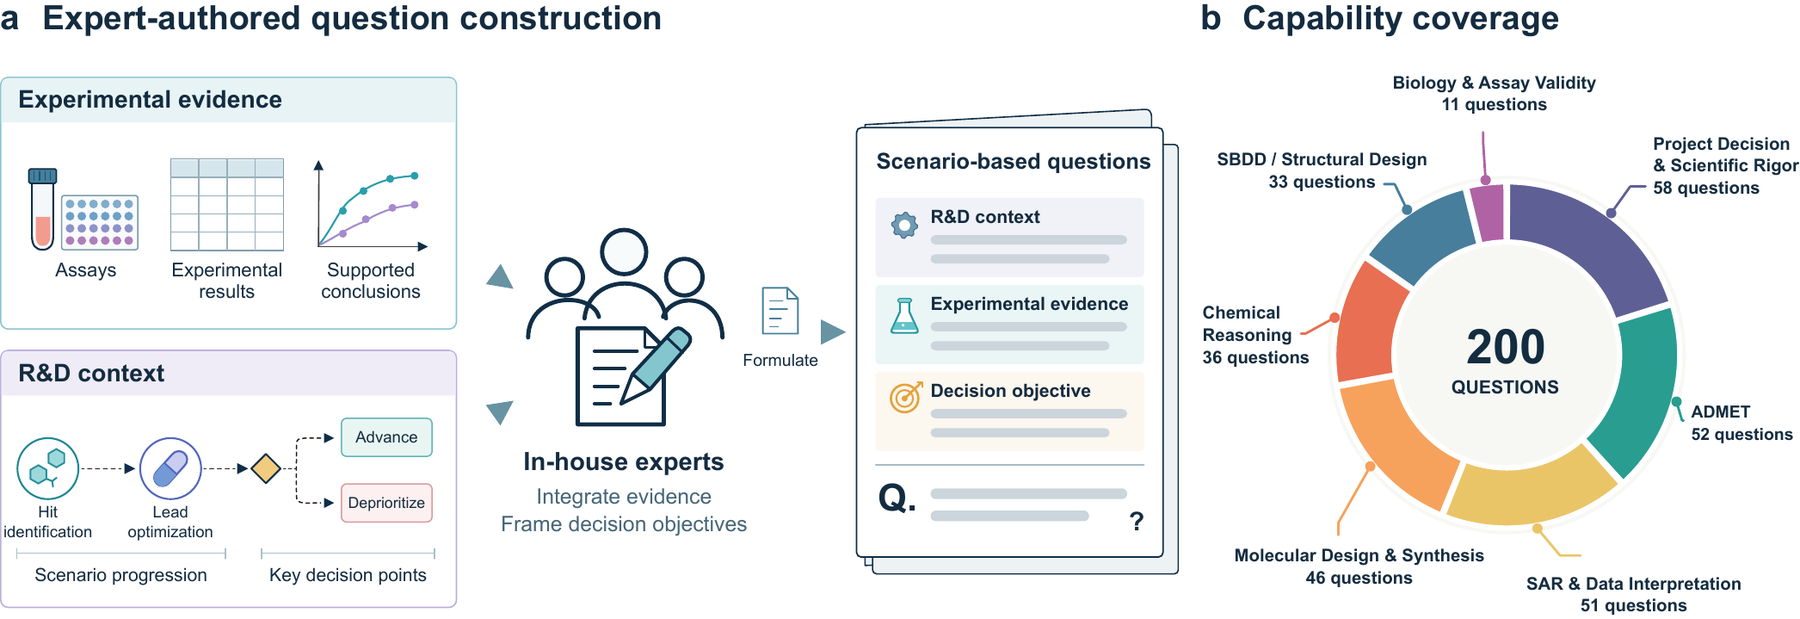
图 3. PharmBench 的构建流程与能力覆盖范围。(a)专家综合实验依据与研发背景,构建基于研发场景的问题。(b)200 个子问题覆盖七个能力维度。
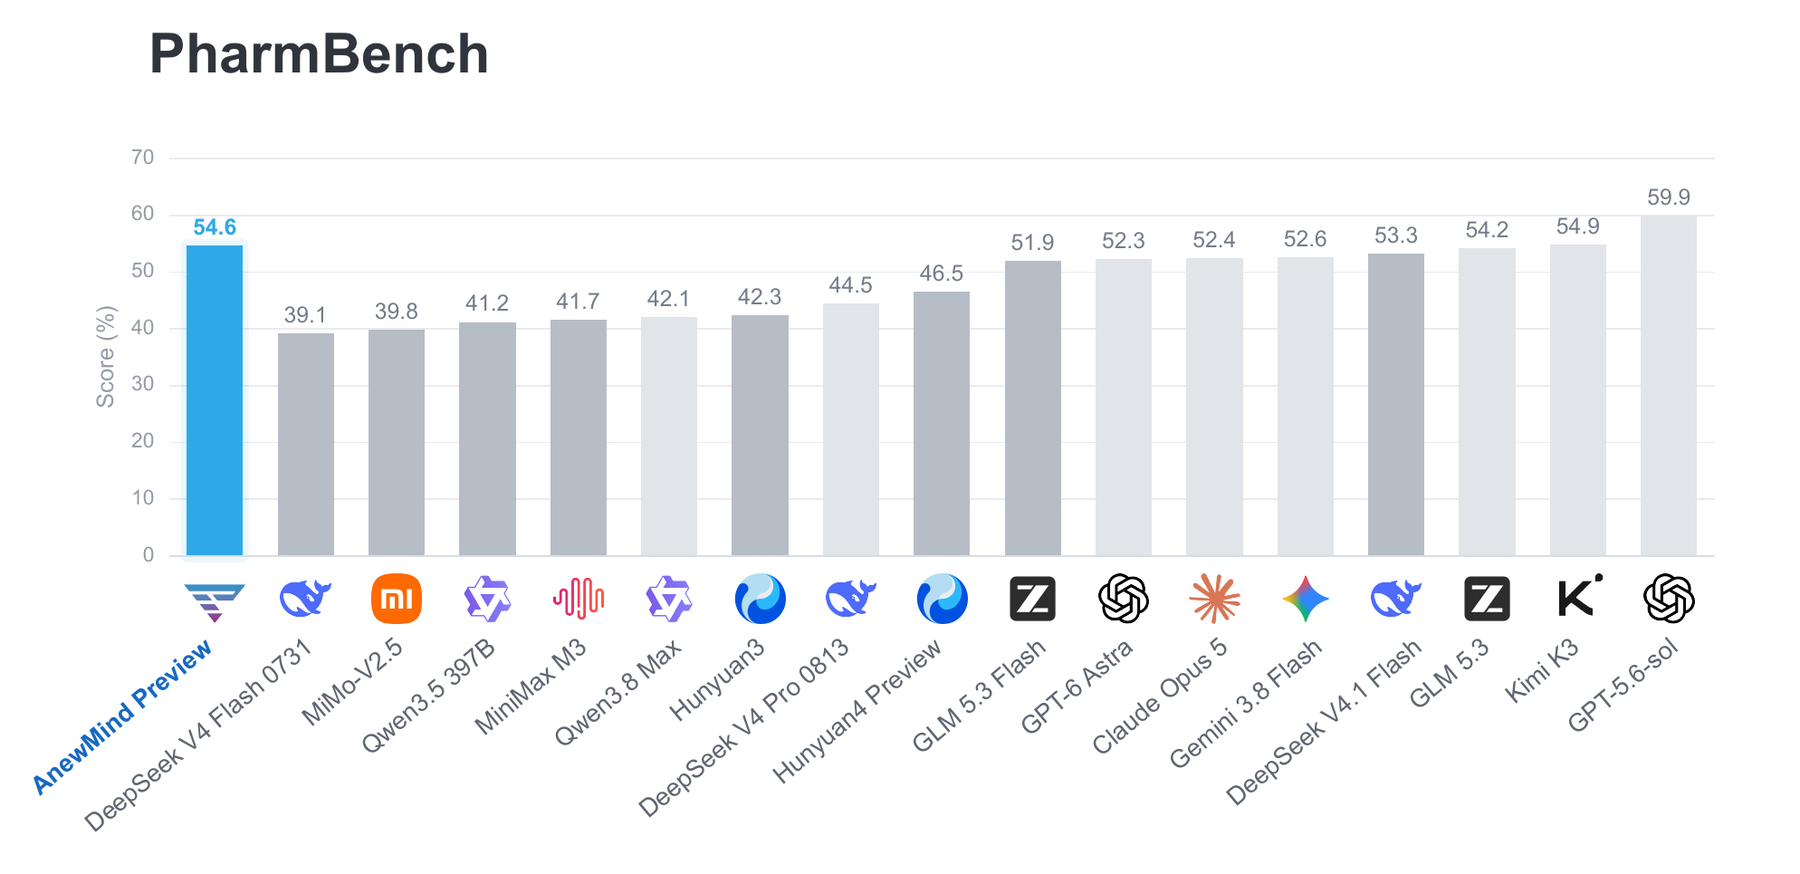
图 4. PharmBench 总体及各能力维度的评测表现。柱状图展示了 17 个模型的加权得分,其中 AnewMind Preview 以彩色突出显示。